本紹介記事では、ICML 2026で採択された論文を対象に、弊社社員がClaude CodeをベースとしたAIエージェントを使用し、論文の再現性を検証した「ICML 2026 Agentic Reproducibility Challenge(筆者訳:国際会議の機械学習論文を対象とした、AIエージェントによる再現性検証 )」に入賞をしたことをご紹介します。
・大会名:ICML 2026 Agentic Reproducibility Challenge(筆者訳:国際会議の機械学習論文を対象とした、AIエージェントによる再現性検証 )
・対象:ICML 2026で採択された機械学習分野の研究論文
・取り組み内容:AIエージェントを用いて論文中の主張を抽出し、実際にコードを実行しながら、その結果が再現できるかを検証
・参加者:Sabari Nathan(デロイトトーマツディープスクエア株式会社所属 シニアエンジニア)
・大会URL:https://huggingface.co/blog/icml-2026-open-reproductions
はじめに
AIの研究論文は毎年数多く発表されていますが、論文に書かれた実験結果を第三者が同じ条件で再実行し、本当に同じ結果が得られるかまで確認される機会は限られています。本大会では、こうした「研究結果の再現性」という課題に対して、AIエージェントを活用しました。参加者はICML 2026で採択された論文の中から対象を選び、AIエージェントに論文を読ませるだけでなく、実際にコードを書かせ、実行し、その結果を論文の主張と照らし合わせながら検証します。
本記事では、なぜこのような大会が行われたのか、AIエージェントとはどのような仕組みなのか、弊社AIエンジニアのSabariさんのClaude CodeをベースにしたAIエージェントでどのように論文の再現性を検証したのか、そして大会全体を通して見えてきたAIと人間の今後の役割について紹介します。
大会概要:ICML 2026 Agentic Reproducibility Challengeとは?
ICMLは「International Conference on Machine Learning」の略で、機械学習分野の研究成果が発表される国際会議です。ICML 2026には23,918本の論文が投稿され、主催者側の資料では6,352本が採択されたとされています。今回の取り組みでは、そうした採択論文を対象に、AIエージェントを使って研究結果の再現性が検証されました。
大会側では、約6,300本の採択論文について、概要と主要な主張を整理していました。参加者はその中から検証したい論文を選び、自分のAIエージェントを使って再現実験を行います。ここでいう主張は、論文に書かれている個別の主張のことです。重要なのは、論文を検証するだけではなく、「どのように検証したのか」まで第三者が確認できることです。今回の大会の目的としては、論文を要約したり「この論文ではこのような結果が報告されています」と説明したりすることではなく、実際にCodeを動かす、または論文の手法を可能な限り忠実に再構築し、実験によって同様の結果が得られるかを確認することが求められました。
なぜ、採択された論文をもう一度検証するのか
ここで一つ疑問が出てきます。「ICMLに採択されているなら、すでに十分チェックされているのでは?」と思われる方もいらっしゃるかもしれません。もちろん、ICMLでは論文がそのまま掲載されるわけではなく、研究者による査読が行われます。
今回の大会の背景には、機械学習研究の規模拡大と、論文の再現性を確認する難しさがあります。特に近年は、研究論文そのものの数が増加しています。機械学習の研究では、論文に新しい手法や実験結果が掲載されても、第三者がすべての実験を再実行して確認できるとは限りません。主催者側の資料では、論文数が増え続けていますが、すべての論文について十分な時間をかけて、すべての証明や実験を細部まで確認できるとは限らないことが指摘されています。機械学習の研究者であっても、その分野は非常に細かく分かれています。複数の領域をまたぐ機械学習の分野では、専門性を持った人でも論文の内容に対する専門性が必ずあるとは限らないのです。
一方で、現在のCoding Agentは、論文を読み、コードを書き、実験を実行し、その結果を整理するところまで進められるようになっています。そこで大会主催者側は、「AIエージェントを使えば、これまで人間だけでは難しかった規模で、論文の再現性を検証できるのではないか」という問いに取り組みました。
論文の再現性を検証することでわかることは、第三者が同じ手法で実行しても同様の結果が得られるのか、公開されているCodeと論文本文に食い違いがないか、特定の実験条件でしか成立しない結果ではないか、長期間または異なるスケールで試した場合にも主張が成立するのか、といった点を確認できます。
生成AIとAIエージェントは何が違うの?
ここで、「生成AIとAIエージェントは何が違うの?」と思う方も多いと思います。
例えば、ChatGPTに論文を渡して、「この論文を要約してください」とお願いした場合、AIは論文を読み、その内容を文章としてまとめてくれます。これが生成AIの代表的な使い方です。AIエージェントには、「この論文に書かれている結果が本当に再現できるか確認してください」という目的を与えます。すると、論文を読むだけでは終わりません。検証する内容を確認し、必要なコードを書き、実際にプログラムを動かし、エラーが出れば原因を調べ、修正してもう一度実行し、最後に論文に書かれた数字と実際の結果を比較します。つまり、生成AIが「文章やコードなどを作ること」を得意としているのに対して、AIエージェントは、その生成AIの能力も使いながら、目的を達成するために複数の作業を進めていく仕組みです。
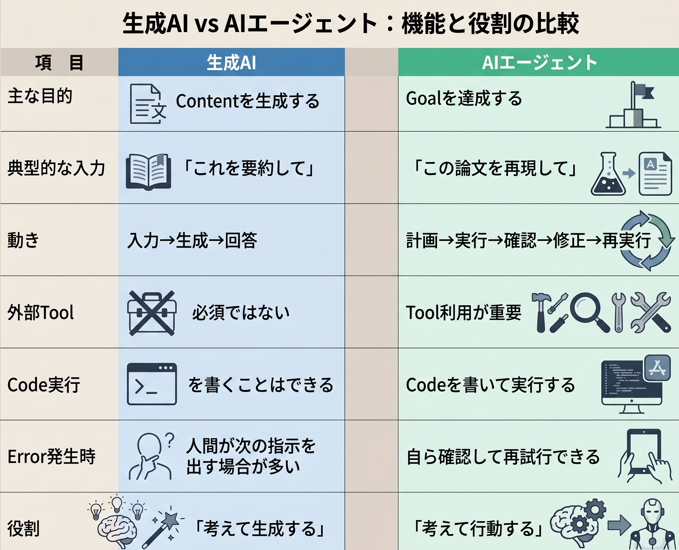
図1 生成AIとAIエージェントの機能と役割の比較
生成AIとAIエージェントの役割を比較すると図1の通りになります。今回の大会では、「この内容で実際に10%向上するのか?」を実際にコードを動かして確認するところまでが求められました。
つまり、生成AIを「与えられた内容に対してコンテンツを生成する仕組み」と考えるなら、AIエージェントは「生成AIなどを頭脳として利用しながら、ツールを操作し、実行・確認・再試行を重ねて目的の達成を目指す仕組み」と捉えると分かりやすいでしょう。
本大会の評価方法
本大会の目的は、あくまでも論文の再現性を確認することであり、正しいと証明することではありません。今回の大会で高い成果として評価されることは、実験の結果再現できた場合はもちろん、論文とは異なる結果になったと明確に示した場合も含まれます。本大会で評価されるフローは以下の図の通りになっております。
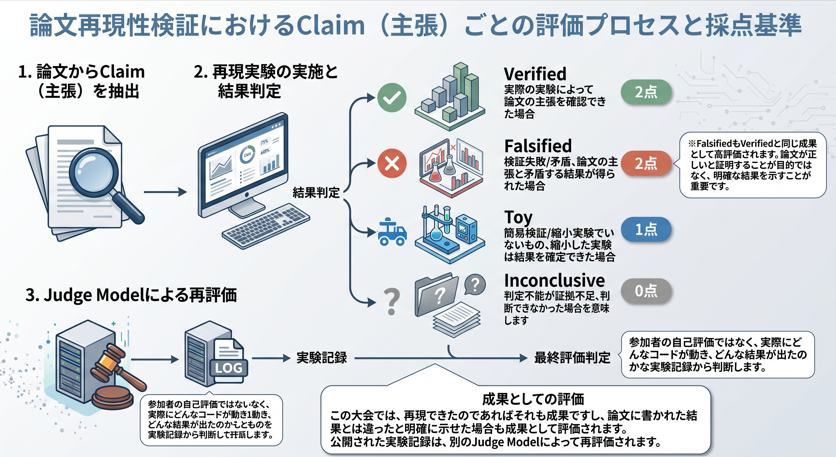
図2 論文再現性検証における評価プロセスと採点基準
はじめに、参加者はICMLにて提出された論文から主張を抽出します。その後、参加者が自身で構築したAIエージェントによる論文の主張の再現を行います。AIによる再現の結果を個別の主張ごとに評価します。評価は「Verified」「Falsified」「Toy」「Inconclusive」の4種類に分類されます。
評価分類
①Verified(実証済):実験によって、論文の主張が確認できた場合。
②Falsified(反証済/矛盾):実験の結果、論文の主張と矛盾する結果が得られた場合。
③Toy(簡易検証済):元論文と同じ規模ではないが、縮小した実験で結果を確認できた場合。
④Inconclusive(判定不能):十分な証拠が得られず、再現の成否判断ができなかった場合。
これらの評価から、各判定に対して、以下のポイントが与えられます。
評価分類のポイント
・Verified(実証済) : 2点
・Falsified(反証済/矛盾) : 2点 (※検証の成果として、Verifiedと同等に評価されます)
・Toy(簡易検証済) : 1点
・Inconclusive(判定不能) : 0点
公開された実験記録は、別のJudge Modelによって再評価されます。Judgeは参加者の自己評価ではなく、実際にどんなコードが動き、どんな結果が出たのかという客観的な事実に基づいた判断をします。
大会参加理由
Sabariさんが参加理由として挙げているのが、機械学習研究における「再現性」の問題です。新しい研究論文は次々と発表されていますが、その一つひとつについて、別の人が同じ実験を行い、本当に同じ結果になるのかまで確認される機会は多くありません。そこで今回、SabariさんはAIエージェントが、論文に書かれた実験を独立してやり直し、その主張が本当に成立するかを判断できるのかを確かめたいと考え、大会に参加しました。また、AIエージェントによる科学的な検証をどこまで信頼できる形で行えるかを試すことも目的でした。
大会に向けて何を準備したのか
Sabariさんは、論文を検証するAIエージェントをClaude Code Skill「icml-paper-repro」として構築しました。今回使用したのは、Claude CodeをベースにしたAIエージェントです。より正確には、Claude CodeのSkill機能を使い、論文の再現性検証に特化した「icml-paper-repro」というSkillを構築しました。Claude Codeに論文を渡してそのまま検証させたのではなく、Claude Codeを土台に、今回の大会向けの手順やルールを組み込んだ専用のAIエージェントを作った、というイメージです。
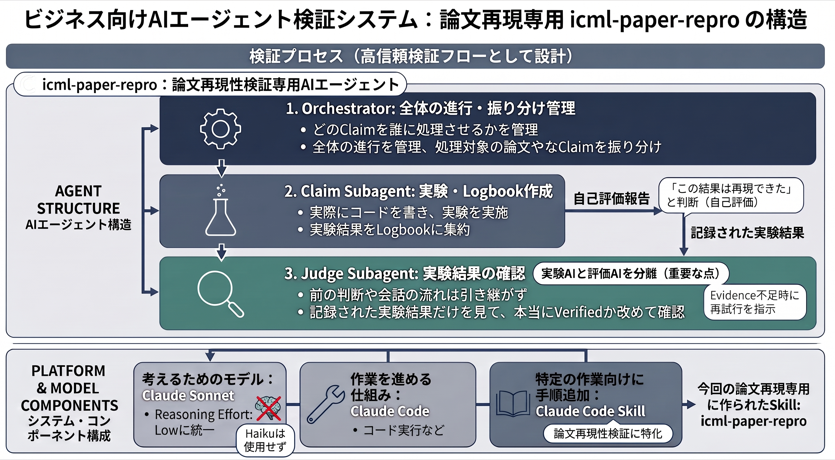
図3 検証システム:論文再現専用 icml-paper-reproの構造
icml-paper-reproの構造は図3の通りになっています。AIモデルの構成を整理すると、Claude Sonnetが「考えるためのAIモデル」、Claude Codeが「そのモデルを使いながらコード実行などの作業を進める仕組み」、Claude Code Skillが「特定の作業向けにルールや手順を追加する仕組み」、そして「icml-paper-repro」が今回の論文再現専用に作られたSkillという関係になります。
そして、今回使用したAIエージェントは、1つのAIにすべてを任せる構成ではなく、役割を3つに分けています。
AIエージェントの3つの役割
①Orchestrator:どのClaimを誰に処理させるか全体の進行を管理し、どの論文やClaimを処理するかを振り分けます。
②Claim Subagent:実際にコードを書き、実験を行い、その結果をLogbookにまとめます。
③Judge Subagent:Claim Subagentが出した実験結果をもう一度確認します。
特に重要なのが、実験を行うAIと、その結果を評価するAIを分けている点です。Claim Subagentが「この結果は再現できた」と判断しても、Judge Subagentにはその判断や会話の流れを引き継がせません。Judge Subagentは、実際に記録された実験結果だけを見て、本当にVerifiedと判断してよいかを改めて確認します。イメージとしては、「全体を管理するAI」「実際に実験するAI」「その実験結果を疑って確認するAI」という3段構成です。
今回の取り組みのポイントは、単に高性能なAIモデルを使ったことではなく、Claude Codeを土台に、誰が実験するのか、誰がその結果を確認するのか、Evidenceが足りない場合にどう再試行するのか、といった役割とルールまで設計したことです。AIエージェントを「自動で何かをしてくれるAI」として使うのではなく、信頼できる検証プロセスとして動かすための仕組みを作ったことが特徴です。
Sabariさんの大会結果と所感
何本の論文を評価し、どのような結果だったのか
Sabariさんの本ポートフォリオでは、計148本の論文から抽出された847件のClaim(主張)を対象に検証評価を実施しました。全体では最大1,694点中1,215点を獲得し、100点換算で72点となりました。また、全評価対象の過半数にあたる54%で実験による明確な結論を導出しており、総合11位(1,193 Points)を記録いたしました。
評価の内訳としては
・Verified:441件(52.1%)
・Falsified:20件(2.4%)
・Toy:293件(34.6%)
・Inconclusive:93件(11.0%)
実験によって検証が成功したVerifiedと、明確に反証されたFalsifiedを合わせると計461件となり、全体847件の54%において実験を通じた明確な結論を得ることに成功しています。残り46%(386件)については、小規模なトイ問題での検証または判断材料不足に留まりました。
インタビューコーナー
こちらでは、Sabariさんに大会で意識されたことをインタビューし、それらを以下の3点でまとめました。
・論文を選ぶときに気を付けたこと
大会では論文を自由に選べるため、どの論文を選ぶかも重要です。今回の再現性を求められる大会では、計算能力よりも選択と正確さを問われるものでした。そのため、今回は主に理論寄りで、検証しやすい論文を優先しました。また、主張が多すぎないことや数式が明確であること、同じ条件なら同じ結果を確認しやすいことも重視しています。すべての論文に同じように挑むのではなく、「限られた時間と環境の中で、どの論文ならきちんと検証できるか」を考えて選ぶことも重要でした。
・Claudeを使うときに気を付けたこと
全体を統括する司令塔としても実務を行う実行役としても適切であるClaudeを使用しました。Claudeを使用するうえで実行環境(OS)の最適化と検証の順番に気を付けました。Claudeの使用にあたって、Linux環境で実行を行いました。Windows環境はLinux環境に比べて再現スコアが低くなる事象を確認したため、今回はWindowsの使用を避けました。また、実験プロセスとして、初めのハードルを論文と同じ条件・同じ規模から検証を開始しました。困難な場合のみ①オープンモデル代替 ➔ ②GPUジョブ活用 ➔ ③代替実験の順にルールに沿って段階的に切り替える運用を行いました。
・ 特に注力したところ
今回、最も力を入れたポイントの一つが、AIが出した結果をそのまま信用せず、「分からないものを、分かったことにしない」しないことに注力しました。今回構築したAIエージェントでは、Verified(実証済)とする場合、わざとインプットを壊したり、ラベルを入れ替えて条件を変えた実験も行いました。これは、条件による差異で同じ結果になってしまうと、その実験は論文の主張を本当に確かめられているとは言いにくいからです。加えて、1度試した結果を別のAIエージェントが確認し、根拠が足りなければ再実験を行いました。最大2回まで再試行しても判断できない場合は、無理にVerified(実証済)とせずInconclusive(判定不能)にしました。分からないものを、分かったことにしないことをAIエージェント設計で重視しました。
大会全体の結果
大会の規模と実績
前章では、個人の実績にフォーカスしましたが、次に大会全体の結果を見てみましょう。
大会全体では、1,221人が登録・参加しました。公開された再現実験のLogbookは6,816件、実際に検証された論文は2,226本です。これは、ICML 2026全体の34%に相当します。さらに、論文の中から評価された主張は35,908件に上りました。
大会全体では、実際にどれくらいの論文を再現できたのでしょうか。検証された2,226本の論文のうち、1,103本(51%)では、少なくとも1件の主張が実験によって確認されました。一方で、すべての主張を再現できた論文は266本でした。
①再現が確認された実績(Verified)
・1,103本:少なくとも1件の主張を実験で確認
・266本:抽出されたすべての主張が完全に再現
②検証上の課題・相反する結果
・496本(23%):少なくとも1件の主張が反証される、または検証が分かれるという結果(Falsified/Contested)
・242本:複数チームの検証で異なる結論(Verdict)が導出
これは、「一度実験して再現できたから正しい」と単純には言えないことも示しています。実験する期間やスケール、実装方法などによって結果が変わる可能性があるためです。
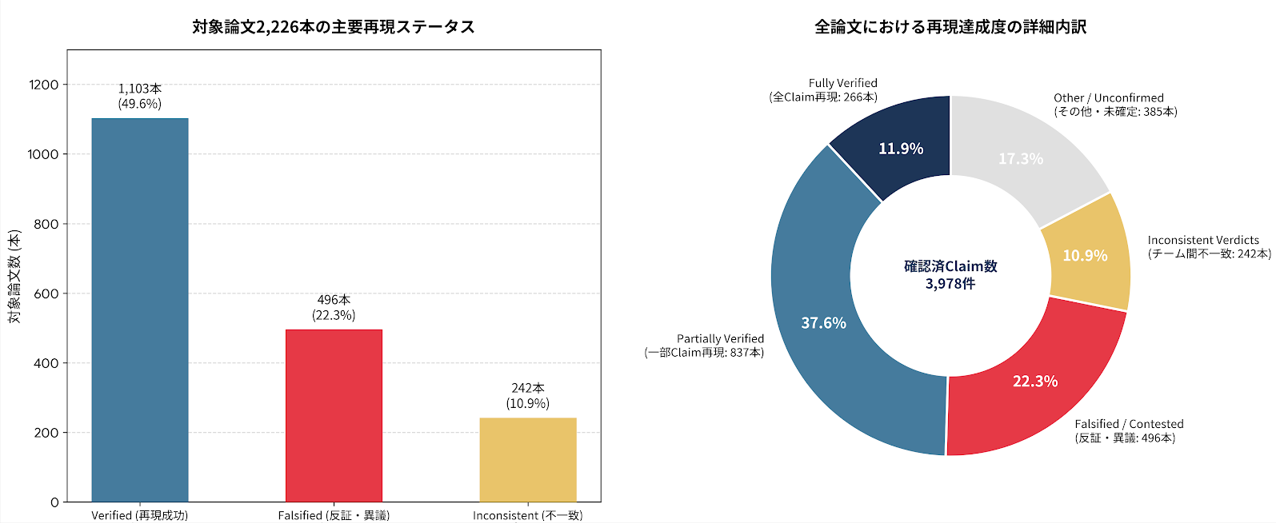
図4 大会全体での論文再現性検証の結果
再現性検証の結果は図4の通りにまとめられます。
AIエージェントの結果そのものが間違うこともある
今回の大会では、AIエージェントによる検証にも問題が起きることが分かりました。ある論文では、少ないステップ数での検証ではClaimが正しいように見えたものの、より長く実験すると反例が見つかりました。実際に3つの独立したチームが、t=224、約3,800、6,416というステップで問題を発見しています。反対に「論文が間違っている」とAIエージェントが判断したものの、その検証側にミスがあったケースもあります。あるLogbookでは、「論文の手法はベースラインより2倍遅い」とされていました。しかし実際には、1件当たりの時間と50件まとめて処理した時間を比較していました。条件を揃えて計算し直すと、参加者自身のデータが、元論文の8倍のスピードアップを支持する結果になりました。つまり、AIエージェントが実験できるようになったからといって、その結論まで自動的に正しくなるわけではありません。
考察
今後、人間は必要なくなるのか
これほどAIエージェントが発達している現状、人間の必要性について考えてしまいますが、今回の実験ではむしろ人間の存在の大きさを感じられるものだったと考えます。今回の実験により、AIエージェントだけで作業を進めると、同じ処理を繰り返すループにはまってしまい、実験のスケールによる違いを見落としたり、単位を取り違えたまま結論を出したりするケースが確認されました。より信頼できる結果につながったのは、人間が途中で、「この前提は本当に正しいか?」「もっと長く実験した方がよいのでは?」「その比較方法で条件は揃っているか?」と問いを投げかけ、必要に応じてAI エージェントの方向を修正したワークフローでした。主催者は、人間の役割を「Manage intelligence effectively」と表現しています。AIにすべてを任せるのではなく、AIが正しく働ける環境を作り、適切な問いを与え、必要な場面では人間が判断する。今回の大会では、その重要性が改めて示されました。
AI時代に求められるのは「AIを使う力」だけではない
今回の大会から見えてくるのは、AIを使うだけではなく、その結果を検証することの重要性です。 生成AIが普及したことで、「AIを使えること」は少しずつ特別なスキルではなくなりつつあります。私たちが必要とされる力は、AIが出した結果をそのまま受け入れるのではなく、「本当にそうなのか」「その実験で十分なのか」「別の条件でも同じなのか」と確認することだと考えます。そして、AIが間違える可能性も前提にしたうえで、検証する仕組みまで設計することが重要です。今回Sabariさんの取り組みでは、論文の選択・環境設定・結果の再確認によりあえて失敗する条件でも検証しました。それでも十分な証拠が得られない場合には、無理に結論を出さず「分からない」と判断しています。このように、AIを使って答えを出すだけではなく、その答えを検証し、信頼できる形にする力も、AIを活用するうえで重要だと分かります。ICML 2026 Agentic Reproducibility Challengeは、AIエージェントが研究を支援できる可能性とともに、AI時代に人間に求められる新しい役割を具体的に示した取り組みになったのではないでしょうか。
参考URL
・ICML 2026 Agentic Reproducibility Challenge:https://huggingface.co/blog/icml-2026-open-reproductions
・ICML:https://icml.cc/